


OpenAI가 9월 10일 Agents API를 공개 베타로 내놨다. 이름만 보면 에이전트를 호출하는 API 하나가 추가된 것처럼 보인다. 그런데 공식 설명을 읽어보면 방향이 조금 다르다. 애플리케이션이 모델을 한 번 호출하는 API가 아니라, Codex가 쓰는 실행 harness를 관리형 서비스로 가져오려는 제품에 가깝다.[1]
OpenAI는 세션, 오케스트레이션, 컨텍스트 압축, 복구를 관리하고, 애플리케이션은 에이전트가 사용할 도구와 실행 환경을 선택한다. 에이전트는 sandbox 안에서 코드를 실행하고 파일을 수정하고 MCP 서버에 연결하고 결과물을 만들 수 있다.[2] 결국 핵심 질문은 “어떤 모델을 쓰나?”보다 “어디까지 실행하게 할 것인가?”가 된다.
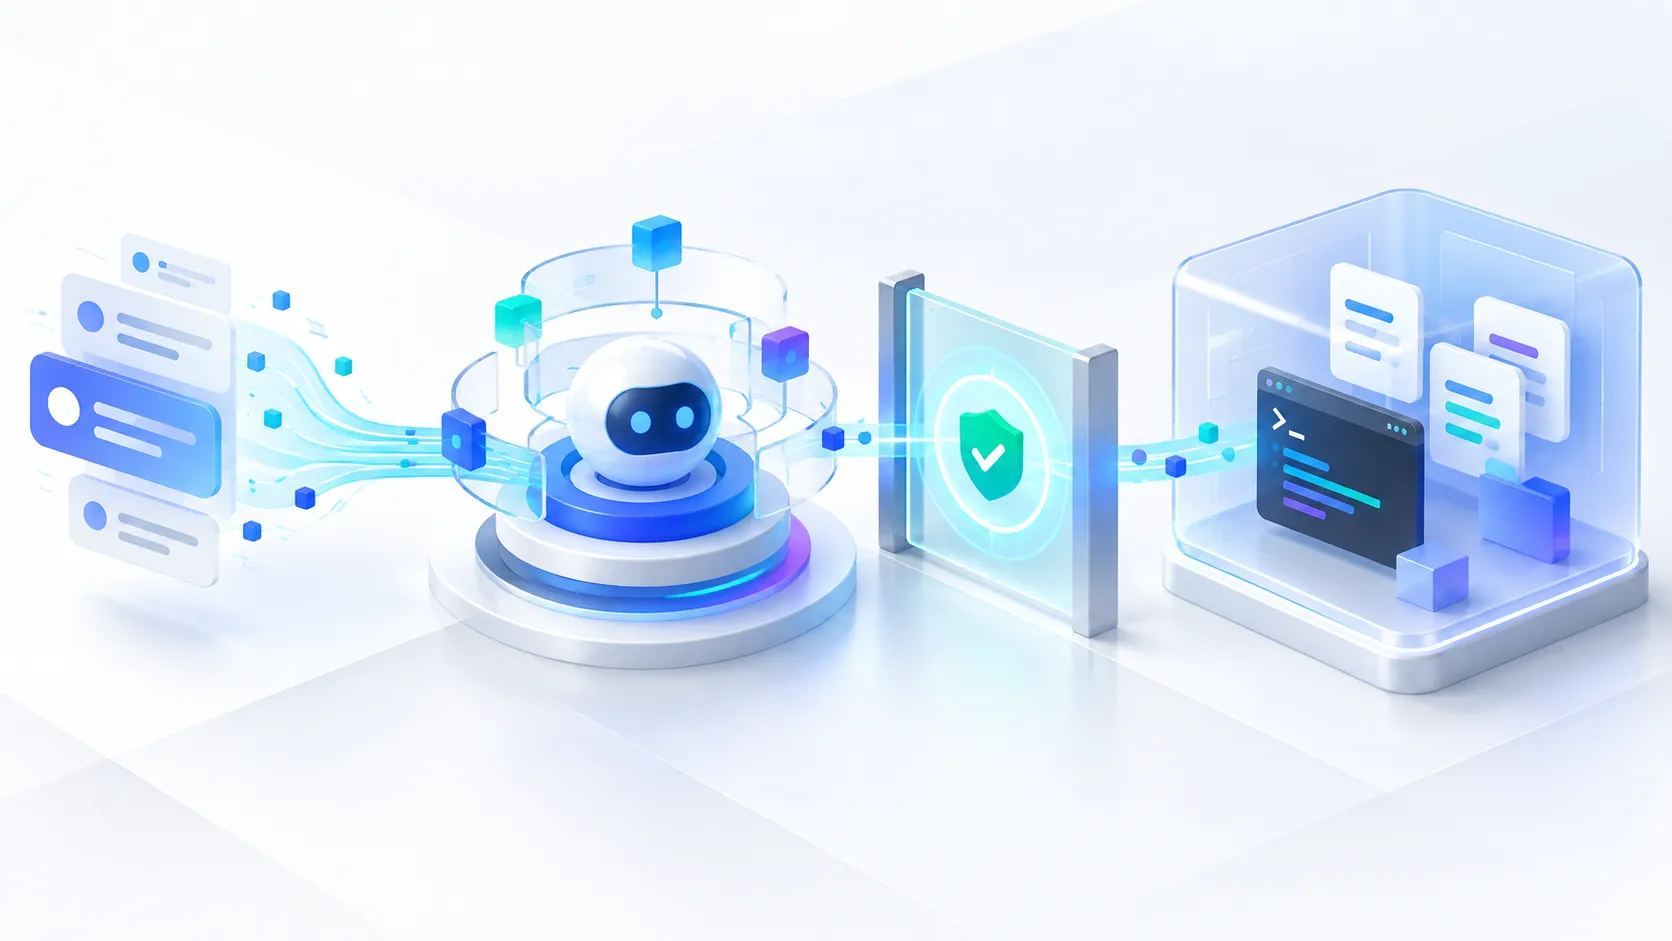
Agents API는 모델 호출 API와 다르다
에이전트의 네 가지 구성요소
Agents API 문서는 제품을 네 가지 개념으로 나눈다. 에이전트는 모델·지시·도구·MCP 서버의 묶음이고, environment는 파일을 읽고 명령을 실행하는 선택적 sandbox다. session은 작업이 이어지는 내구성 있는 실행 단위이며, events와 items는 입력과 진행 결과를 표현한다.[2]
이 구분이 중요한 이유는 애플리케이션의 책임이 모델 요청과 응답 사이에서 끝나지 않기 때문이다. 일반적인 LLM 호출에서는 요청을 보내고 텍스트를 받아 저장하면 된다. 에이전트는 그 사이에 파일 변경, 셸 명령, 외부 도구, 재시도, 중단, 재개가 들어간다. 응답 본문 하나만 저장해서는 작업이 무엇을 했는지 설명할 수 없다.
내가 이 API를 제품에 붙인다면 첫 번째 데이터 모델부터 다음처럼 나눌 것 같다.
request: 누가 어떤 작업을 요청했는가session: 어느 에이전트 실행에 연결됐는가tool_call: 어떤 도구를 어떤 인자로 호출했는가artifact: 파일·패치·보고서처럼 무엇을 만들었는가approval: 사람이 어느 경계를 승인했는가outcome: 성공·실패·중단·재개 중 무엇인가
이 기록이 있어야 “에이전트가 답을 잘했다”가 아니라 “이 사용자의 요청이 이 디렉터리에서 이 도구를 호출했고, 이 결과물을 남긴 뒤 검증을 통과했다”고 말할 수 있다. Agents API가 실행 루프를 대신 운영해준다고 해서 제품의 감사 로그까지 자동으로 완성되는 것은 아니다.
관리형 harness가 줄여주는 일과 남기는 일
직접 만들던 실행 루프를 넘길 수 있다
공식 발표에서 Agents API는 장시간 작업을 위한 harness와 인프라를 제공한다고 설명한다. 컨텍스트를 관리하고, 도구를 효율적으로 사용하고, 필요하면 서브에이전트로 나누고, 파일과 코드를 다루는 환경을 계속 유지하는 역할이다.[1] 문서의 예시도 디렉터리 트리 생성, 릴리스 노트 비교, 인시던트 대응, GitHub 이슈 조사처럼 한 번의 답변보다 긴 작업을 전제로 한다.[2]
이건 작은 차이가 아니다. 팀이 직접 에이전트를 만들면 모델 호출보다 주변 코드가 더 커진다. 세션 상태를 어디에 둘지, 긴 대화가 한도에 도달하면 어떻게 줄일지, 도구 호출을 어떤 순서로 재시도할지, 중간에 연결이 끊기면 어디서 재개할지 결정해야 한다. 관리형 harness는 이 반복 작업을 제품 바깥으로 밀어낸다.
대신 책임의 위치가 바뀐다. 실행 루프를 직접 구현하지 않는 만큼, 애플리케이션은 어떤 도구와 파일을 노출할지, 어떤 이벤트를 사용자에게 보여줄지, 실패한 작업을 언제 중단할지를 더 명확히 선언해야 한다. “harness를 우리가 관리하지 않는다”와 “작업 결과의 책임이 없다”는 같은 말이 아니다.
실행 환경이 곧 권한 경계다
OpenAI-hosted sandbox를 선택하면 OpenAI가 세션 환경을 준비하고 관리한다. 애플리케이션은 세션을 만들고 입력을 보내고, 이벤트나 webhook으로 진행 상황을 받는다.[2] 편한 구조지만 sandbox를 단순한 임시 컨테이너로 보면 안 된다. 에이전트가 코드를 실행하고 파일을 수정할 수 있다면, 그 안에 무엇을 넣고 무엇을 넣지 않을지가 제품 보안 정책이 된다.
자체 환경을 연결하는 방식도 제공된다. 이 경우 OpenAI가 harness를 실행하고, 사용자의 환경 안에서 codex exec-server가 명령 실행·파일 읽기·파일 쓰기·로컬 MCP 연결을 담당한다. executor는 제한된 키로 등록한 뒤 outbound WebSocket으로 명령을 받고 결과를 돌려준다.[4]
여기서 특히 눈에 들어온 문장이 있다. 환경을 사용자나 workload 단위로 격리해야 하고, 같은 환경을 공유하는 에이전트는 같은 파일·자격증명·리소스에 접근할 수 있다는 경고다.[4] 에이전트 기능을 빨리 붙이려다 하나의 작업 디렉터리와 하나의 광범위한 키를 여러 세션이 공유하면, 모델이 아무리 좋아도 경계는 이미 무너진다.
자체 환경을 쓸 때는 executor 키도 별도로 다뤄야 한다. 문서에 따르면 이 키는 환경 연결만 허용하고 다른 API 작업은 허용하지 않는 제한된 키여야 하며, 소스 코드·컨테이너 이미지·로그에 넣으면 안 된다.[4] “에이전트가 읽을 수 있는 키”와 “전체 API를 호출할 수 있는 키”를 분리하는 방식은 좋은 기본값이다.
긴 작업에서 컨텍스트 압축이 의미하는 것
기억을 줄이는 것과 기록을 보존하는 것은 다르다
장시간 에이전트의 가장 현실적인 문제는 컨텍스트 창이다. Agents API는 이전 작업을 요약해 다음 단계에 넘기는 컨텍스트 관리와 compaction을 제공한다.[1] 별도 문서의 설명처럼 compaction은 긴 상호작용을 더 작은 컨텍스트로 줄이면서 다음 작업에 필요한 상태를 보존하려는 기능이다.[3]
서버 측 compaction 결과에는 이전 상태와 추론을 전달하는 불투명한 compaction item이 들어간다. 이 값은 사람이 읽는 작업 일지가 아니다.[3] 그래서 compaction을 켰다는 사실만으로 감사 가능성이 생기지는 않는다. 오히려 제품은 사람이 읽을 수 있는 체크포인트를 별도로 남겨야 한다.
예를 들면 다음 정도는 에이전트가 압축되기 전에 애플리케이션이 저장해야 한다.
- 현재 목표와 완료 조건
- 이미 실행한 도구와 중요한 결과
- 변경한 파일 목록과 diff 요약
- 아직 확인하지 않은 위험
- 다음 단계에서 필요한 승인
- 실패하면 되돌릴 수 있는 복구 지점
에이전트가 긴 작업을 이어갈 수 있다는 것은 생산성 기능이다. 하지만 “이전 맥락을 기억한다”와 “왜 이 변경을 했는지 사람이 재구성할 수 있다”는 별개의 품질 기준이다. 전자는 harness가 도울 수 있고, 후자는 제품의 이벤트 모델과 저장 정책이 책임져야 한다.
토큰을 줄이는 것보다 되풀이를 줄이는 게 먼저다
컨텍스트 압축은 비용과 지연을 줄일 수 있지만, 너무 많은 정보를 제거하면 에이전트가 같은 파일을 다시 읽거나 명령을 다시 실행할 수 있다. 그러면 한 번의 입력은 짧아져도 전체 작업은 길어진다. 따라서 compaction의 성공을 “토큰이 얼마나 줄었나” 하나로 판단하면 안 된다.
내가 볼 지표는 작업 완료율, 재실행 횟수, 복구 후 오류율, 평균 작업 시간, 사용자 승인 횟수에 가깝다. 짧아진 컨텍스트가 실제로 작업을 빠르게 끝냈는지, 아니면 모델의 재탐색 비용을 늘렸는지를 함께 봐야 한다.
이 관점은 이전에 썼던 AI 코딩 에이전트 테스트와 검증의 한계와도 연결된다. 실행 흔적이 남았다는 사실과 실제 품질이 좋아졌다는 결과를 분리해야 하듯, 컨텍스트가 압축됐다는 사실과 작업이 효율적으로 끝났다는 결과도 분리해야 한다.
도구와 MCP를 켜는 순간 제품의 표면이 넓어진다
Agents API는 MCP, 사용자 정의 함수, 웹 검색 같은 도구를 지원하고, 필요한 도구 정의를 검색해 가져오거나 도구 호출을 코드에서 병렬·연쇄 처리하는 흐름도 제공한다.[1] 이 기능은 에이전트가 긴 도구 목록을 매번 모두 읽지 않아도 된다는 점에서 유용하다.
하지만 도구 검색은 보안 정책의 대체물이 아니다. 에이전트가 발견할 수 있는 도구의 집합 자체가 권한 모델이기 때문이다. 다음 도구가 함께 등록되어 있다고 생각해보자.
read_repository
write_workspace
run_tests
send_message
apply_production_migration
모델이 마지막 도구를 선택하지 않았다고 해서 설계가 안전한 것은 아니다. 다음 작업이나 프롬프트 주입, 도구 설명의 모호함, 잘못된 리소스 식별자가 경계를 흔들 수 있다. 위험한 도구는 검색 결과에서 숨기는 것만으로 끝내지 말고, 사용자·작업 유형·대상 리소스·승인 상태를 서버에서 다시 확인해야 한다.
실무에서는 도구를 기능 이름이 아니라 위험도와 영향 범위로 나누는 편이 낫다.
- 읽기: 저장소·문서·로그 조회
- 제한된 쓰기: 전용 작업 디렉터리 안의 파일 수정
- 외부 호출: 이슈·메시지·티켓 생성
- 고위험 변경: 배포, 데이터베이스 쓰기, 권한 변경
앞의 두 단계는 자동화하더라도, 외부 호출과 고위험 변경은 사람 승인이나 별도 서비스 계층을 통과하게 한다. 에이전트에게 도구를 주는 일은 기능을 추가하는 일인 동시에 새로운 API 표면을 공개하는 일이다.
처음 도입한다면 어디까지 맡길까
Agents API를 처음 붙이는 팀이라면 “우리 업무를 전부 자동화하는 에이전트”부터 만들지 않는 편이 좋다. 다음처럼 실패해도 피해가 제한된 작업 하나를 고른다.
- 사용자의 요청을 읽기 전용으로 조사한다.
- 필요한 파일과 로그를 수집한다.
- 원인과 후보 변경을 보고서로 만든다.
- 패치나 티켓은 초안으로만 만든다.
- 사람이 승인하면 다음 작업 세션에서 제한된 쓰기를 수행한다.
작업 지시에도 운영 경계를 직접 적어둔다.
- 기본 모드는 읽기 전용이다.
- 쓰기는 지정된 workspace 디렉터리에서만 허용한다.
- 비밀값, 인증서, 개인키, 운영 데이터는 읽지 않는다.
- 외부 메시지 전송과 운영 환경 변경은 승인 없이는 실행하지 않는다.
- 각 도구 호출과 생성 artifact를 기록한다.
- 실패하면 추측으로 완료하지 말고 중단 이유와 다음 조치를 보고한다.
이 정도의 제한은 에이전트의 능력을 줄이는 장치라기보다, 어떤 상황에서 자동화가 멈춰야 하는지를 알려주는 계약에 가깝다. 자동화의 첫 성공 기준도 “사람 없이 끝났다”가 아니라 “사람이 검토할 수 있는 상태로 반복해서 도달했다”로 잡는 게 맞다.
OpenAI Agents API는 애플리케이션이 장시간 작업을 수행하는 데 필요한 실행기를 직접 만들지 않아도 된다는 점에서 매력적이다. 특히 세션, 도구, sandbox, compaction, 서브에이전트가 한 흐름 안에 들어온다. 하지만 이 편리함 때문에 책임이 사라지는 것은 아니다. 오히려 모델 호출과 실행 환경 사이의 경계를 제품 설계에서 더 선명하게 그어야 한다.
내가 첫 배포에서 확인할 항목은 모델 점수가 아니다. 세션이 사용자와 workload별로 격리되는지, 읽기와 쓰기 도구가 분리되는지, compaction 전후의 체크포인트를 사람이 읽을 수 있는지, 실패한 작업을 중단·재개할 수 있는지, 운영 변경 앞에 승인 지점이 있는지다.
에이전트를 서비스에 붙이는 순간 제품은 답변을 생성하는 시스템에서 작업을 수행하는 시스템으로 바뀐다. Agents API는 그 전환에 필요한 harness를 제공한다. 남은 일은 우리가 그 harness에 어떤 도구를 연결하고, 어떤 권한을 주고, 어디에서 멈추게 할지 정하는 것이다.
Sources
[1] https://openai.com/index/introducing-the-agents-api [2] https://developers.openai.com/api/docs/guides/agents-api/overview [3] https://developers.openai.com/api/docs/guides/compaction [4] https://developers.openai.com/api/docs/guides/agents-api/environments/self-hosted